Cloudflare e i bot IA: l'impostazione che può tagliare fuori Googlebot senza avvisare
 Di Thierry Gustin
Aggiornato il
7 min di lettura
Indice
Dal 1° luglio 2026 Cloudflare permette a tutti i suoi clienti, piano gratuito compreso, di bloccare i bot IA in base a tre usi: ricerca, agente e addestramento[1]. Ed è qui la trappola: se scegli di bloccare i bot IA di addestramento, Cloudflare blocca anche i crawler polivalenti come Googlebot, Bingbot e Applebot, che servono sia alla ricerca sia all'IA. Un'impostazione pensata per proteggere i tuoi contenuti può quindi farti sparire da Google.
Il tema riguarda molte PMI, in Francia come in Spagna: Cloudflare viene spesso attivato dall'hosting o dall'agenzia al momento della messa online, e poi nessuno guarda più le sue impostazioni. Con il senno di novembre 2026, e con i nuovi valori predefiniti in vigore dal 15 settembre, è uno dei primi punti che controllo durante un audit.
Che cosa ha cambiato Cloudflare il 1° luglio 2026?
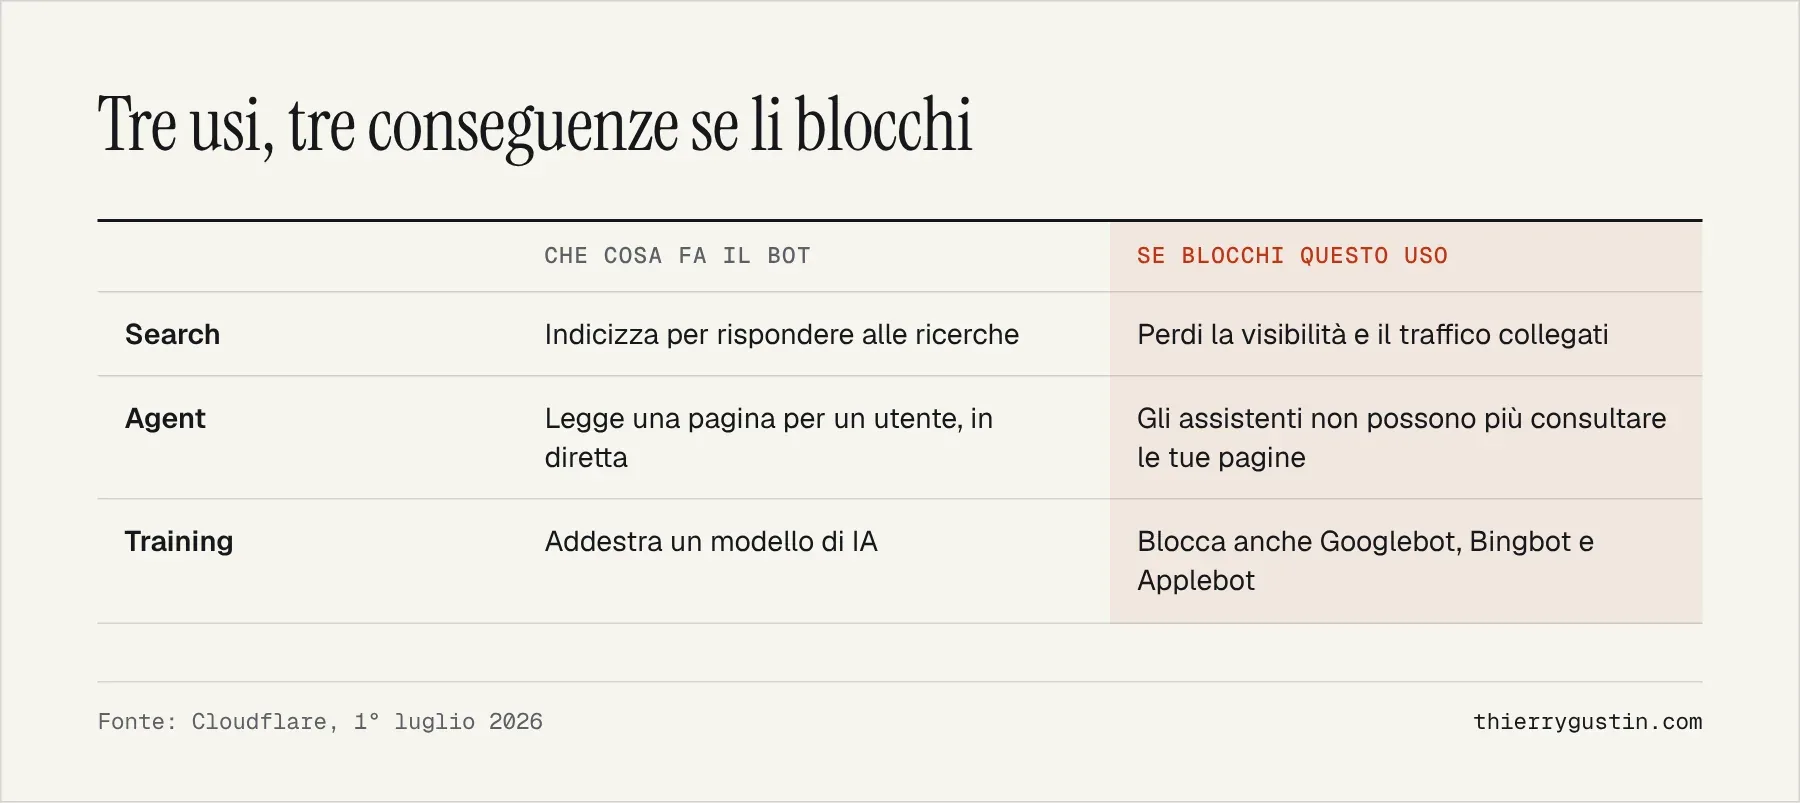
Per il suo secondo « Content Independence Day », Cloudflare ha riorganizzato la gestione dei bot attorno a tre usi[1]. Search: il bot costruisce un indice per rispondere più avanti alle ricerche, e il sito può aspettarsi traffico in cambio. Agent: il bot agisce in tempo reale per conto di una persona, come un assistente che va a leggere una pagina durante una conversazione. Training: il contenuto serve ad addestrare un modello e ci resta assorbito per sempre.
Secondo cambiamento, più discreto: essere un bot « verificato » non significa più essere autorizzato per impostazione predefinita. Cloudflare scrive che non considera più « Verified » come « default allowed »: un bot verificato ora è autorizzato o no a seconda della categoria in cui rientra[1].
Terzo cambiamento, quello che crea problemi: i bot che mescolano ricerca e addestramento vengono giudicati sull'insieme dei loro usi, e si applica la regola più restrittiva. Cloudflare lo scrive senza giri di parole: Googlebot, Applebot e Bingbot « will be blocked by customers who have selected to block Training »[1].
Perché bloccare l'addestramento può bloccare Googlebot?
Perché Google usa gli stessi crawler per la ricerca e per i suoi prodotti di IA. La sua documentazione lo spiega: il token Google-Extended, che permette di rifiutare l'uso dei tuoi contenuti per addestrare i futuri modelli Gemini, non ha uno user agent proprio, e la scansione avviene con i normali crawler di Google[2]. Visto da Cloudflare, Googlebot spunta quindi sia la casella ricerca sia la casella addestramento.
La differenza è fondamentale. Rifiutare l'addestramento tramite Google-Extended nel tuo robots.txt non ha alcun effetto sulla ricerca: Google precisa che questo token « does not impact a site's inclusion in Google Search » e non è un segnale di ranking[2]. Bloccare Googlebot a livello di firewall, invece, gli impedisce di leggere le tue pagine, con le conseguenze che si possono immaginare sull'indicizzazione.
Cloudflare propone anche di arricchire il robots.txt con un segnale di preferenza, in fase di test, del tipo « Content-Signal: search=yes,ai-train=no,use=reference »[1]. È la stessa Cloudflare a precisare che questi valori esprimono una preferenza e non bloccano nulla: nessun bot è obbligato a rispettarli. Non ci farei affidamento per proteggere alcunché, né per regolare il rapporto con Google.
Che cosa cambiano i valori predefiniti del 15 settembre 2026?
Dal 15 settembre 2026 i nuovi domini aggiunti a Cloudflare ricevono impostazioni predefinite più severe: sulle pagine che mostrano pubblicità, i bot di addestramento e gli agenti sono bloccati, mentre la ricerca resta autorizzata[1]. I clienti esistenti potevano sottrarsi a questa modifica nelle impostazioni di sicurezza prima di quella data.
Per una PMI, due situazioni meritano una verifica. Se il tuo sito è stato migrato o ricreato su Cloudflare dopo il 15 settembre e mostra pubblicità, gli agenti IA (quelli che leggono una pagina durante una conversazione) possono essere bloccati senza che nessuno l'abbia deciso. E se qualcuno ha spuntato « blocca l'addestramento » a fin di bene, Googlebot può essere coinvolto, qualunque sia l'età del dominio.
I bot IA pesano davvero così tanto?
Sì, ed è questo che spiega la reazione di Cloudflare. Secondo il suo rapporto sui bot, l'addestramento delle IA rappresentava il 52% delle richieste dei crawler a giugno 2026, contro il 22% della primavera 2025. Più della metà del traffico Internet non è più umano[3].
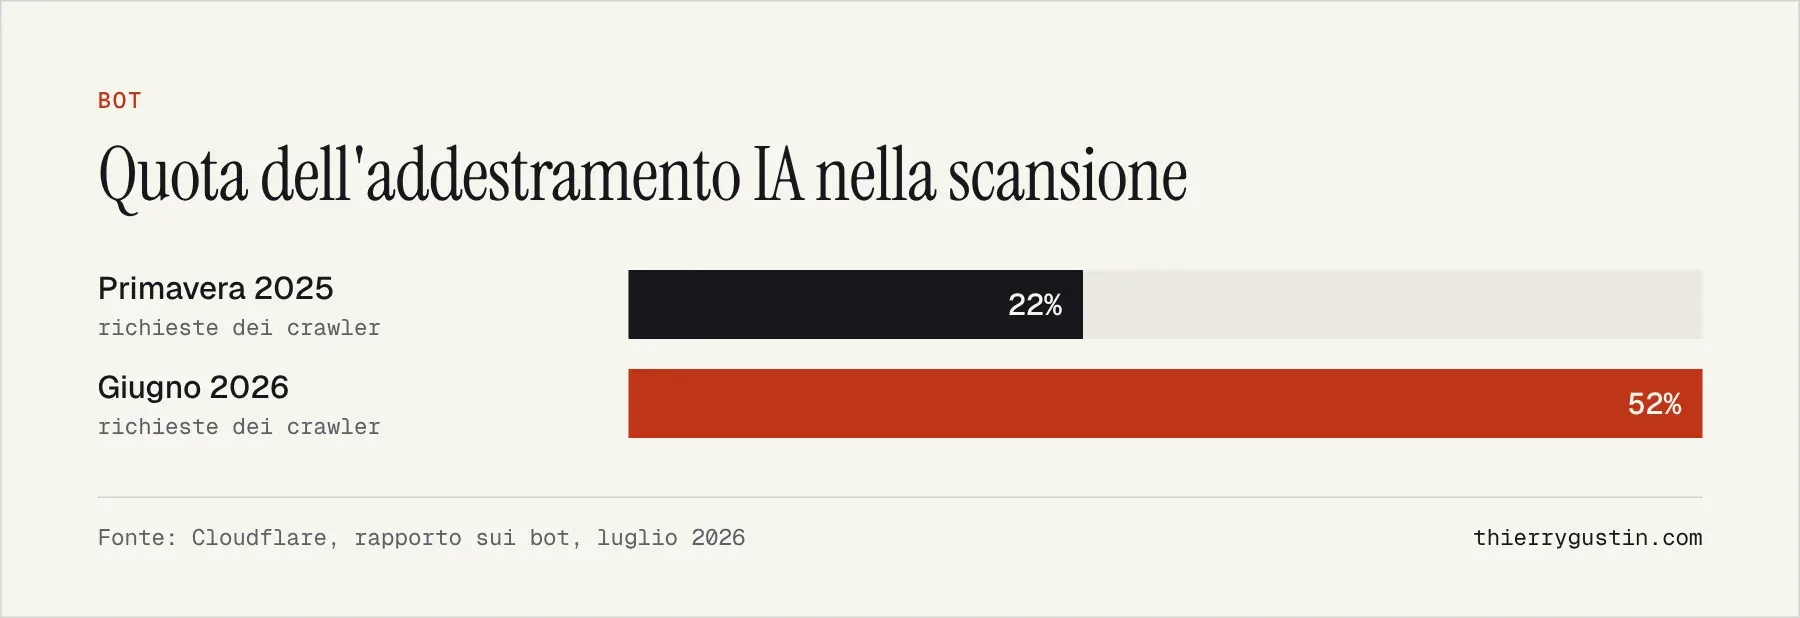
Dall'altra parte, il traffico restituito resta concentrato: Google rappresenta circa l'88% del traffico di referral osservato da Cloudflare[3]. In altre parole, la maggior parte dei bot scansiona per addestrare, mentre il grosso delle visite continua ad arrivare da un solo motore. È proprio per questo che bisogna bloccare con precisione, e mai a scapito di Googlebot.
Cloudflare sta anche testando un modello « Pay Per Use », evoluzione del suo pagamento per scansione, con Ceramic.ai e You.com, riconoscendo che si tratta di un esperimento[4]. Per una PMI è da seguire, non da inserire in un business plan.
Che cosa ne penso
L'intenzione di Cloudflare è legittima: dare ai siti un modo semplice per rifiutare che i loro contenuti alimentino modelli senza contropartita. Ma la scelta di bloccare i crawler polivalenti quando si rifiuta l'addestramento trasforma un'impostazione di principio in un rischio commerciale. Pochi titolari di PMI sanno che spuntare una casella « IA » può tagliare fuori Google.
La mia posizione con i clienti è semplice. Per un'azienda che vende servizi o prodotti, essere letta dai motori di ricerca e dagli assistenti è un patrimonio: è ciò che permette di essere citati in una risposta di Google, di ChatGPT o di Claude. Consiglio di lasciare aperti Search e Agent, e di gestire la questione dell'addestramento nel robots.txt, bot per bot, anziché nel firewall.
Il caso degli editori il cui contenuto è il prodotto (stampa, studi a pagamento, corsi) è diverso; per loro bloccare l'addestramento è un'opzione da valutare. Ma anche in quel caso preferisco Google-Extended e l'impostazione di esclusione di Search Console, aperta a tutti i siti dal 31 agosto 2026[5], a un blocco brutale di Googlebot. Queste due leve separano chiaramente la ricerca dall'IA.
Che cosa fare in concreto?
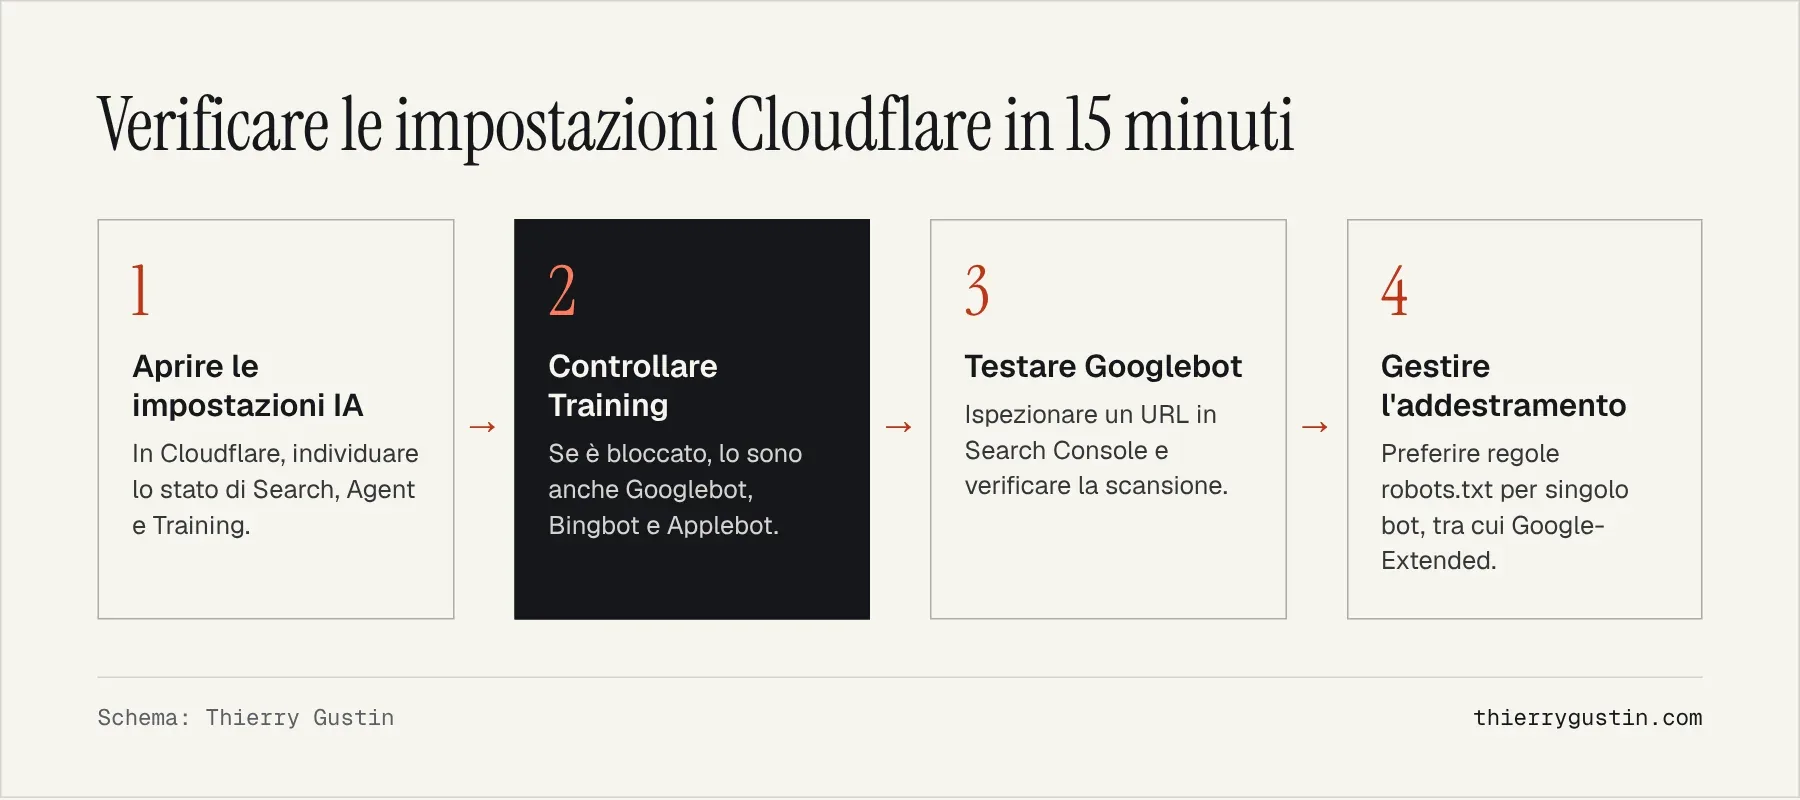
Fai l'inventario. Chiedi al tuo hosting o alla tua agenzia se il sito passa da Cloudflare e chi vi ha accesso. Molte PMI scoprono in quell'occasione che nessun dipendente possiede le credenziali.
Fai il test con Google stesso. Lo strumento Controllo URL di Search Console mostra se Googlebot è riuscito a scansionare una pagina di recente. Un errore di scansione improvviso, senza modifiche al sito, deve far pensare al firewall.
Scrivi la tua politica nel robots.txt. È l'unico posto leggibile da tutti, ed è il metodo che descrivo nella sezione robots della guida GEO. Per controllare poi che cosa recupera un bot, il crawler open source Arachnide percorre il tuo sito come farebbe un motore. È invece inutile aggiungere un file llms.txt per Google: a giugno ha precisato che non gli serve[6].
Domande frequenti
Bloccare i bot IA in Cloudflare può danneggiare il mio posizionamento su Google?
Sì, se blocchi la categoria Training. Dal 1° luglio 2026 Cloudflare applica la regola più restrittiva ai crawler polivalenti: Googlebot, Bingbot e Applebot vengono bloccati presso i clienti che rifiutano l'addestramento. Googlebot non può più scansionare le tue pagine, e questo ne minaccia l'indicizzazione e il posizionamento.
Come rifiutare l'addestramento di Gemini senza bloccare Googlebot?
Aggiungi una regola per il token Google-Extended nel tuo robots.txt. Google indica che questo token controlla l'uso dei contenuti per addestrare i modelli Gemini, senza effetti sull'inclusione nella ricerca né sul ranking. È più preciso di un blocco nel firewall, che non distingue gli usi di uno stesso bot.
Che cosa hanno cambiato le impostazioni Cloudflare del 15 settembre 2026?
Per i nuovi domini aggiunti a Cloudflare dal 15 settembre 2026, i bot di addestramento e gli agenti IA sono bloccati per impostazione predefinita sulle pagine che mostrano pubblicità. I bot di ricerca restano autorizzati. I clienti esistenti potevano sottrarsi prima di quella data nelle impostazioni di sicurezza.
Bisogna bloccare gli agenti IA come quelli di ChatGPT o Claude?
Per la maggior parte delle PMI, no. Gli agenti leggono una pagina in diretta per rispondere a un utente, spesso con un link alla fonte. Bloccarli significa rinunciare a essere consultati e citati proprio quando un potenziale cliente fa la sua domanda. Il blocco si giustifica soprattutto per i contenuti a pagamento.
Fonti
- Cloudflare, Content Independence Day: opzioni Search, Agent e Training (1° luglio 2026, aggiornato il 15 luglio)
- Google Search Central, crawler comuni di Google e token Google-Extended
- Cloudflare, rapporto sui bot e sull'Internet agentico (1° luglio 2026)
- Cloudflare, « Making AI search smarter », da Pay Per Crawl a Pay Per Use (1° luglio 2026)
- Google, nuovo controllo delle funzionalità di IA generativa in Search Console (3 giugno 2026, aggiornato il 31 agosto 2026)
- Google Search Central, registro degli aggiornamenti della documentazione (voce del 15 giugno 2026 su llms.txt)